Vos applications sont au cœur de votre activité. Site web, application mobile, ERP ou plateforme SaaS : leur bon fonctionnement conditionne la satisfaction de vos utilisateurs, la productivité de vos équipes et votre chiffre d'affaires. Pourtant, beaucoup d'entreprises n'ont aucune visibilité sur l'état réel de leurs applications et découvrent les problèmes en même temps que leurs clients.
La supervision applicative répond à ce besoin : surveiller en continu la performance, la disponibilité et la qualité de service de vos applications pour détecter les incidents avant qu'ils ne deviennent critiques. Avec des applications de plus en plus distribuées (cloud, API, services tiers), cette démarche devient un élément de base de l'exploitation.
Cet article s'adresse aux dirigeants et responsables IT de TPE, PME et grandes entreprises, au Maroc comme à l'international. Unziptech, agence de développement logiciel basée à Fès, conçoit, développe et maintient des applications web, mobiles et métier, et propose l'hébergement, la supervision et la sauvegarde des plateformes en ligne qu'elle exploite. Nous présentons ici une approche pratique de la supervision applicative : définition, enjeux, indicateurs clés de performance, outils et liens avec la maintenance et le plan de reprise d'activité.
Définition de la supervision applicative et liens avec la supervision informatique
La supervision applicative est une brique de la supervision informatique. Elle se concentre sur la performance et la disponibilité des applications (web, mobiles, SaaS ou progiciels métier) et sur ce que vivent réellement les utilisateurs. Elle surveille les applications en temps réel et permet de détecter rapidement les incidents et les ralentissements.
Voici comment elle s'articule avec les autres dimensions de la surveillance :
- Supervision applicative : transactions, temps de réponse, erreurs et taux de réussite des parcours utilisateurs.
- Supervision réseau : connectivité, bande passante, latence et équipements réseau (routeurs, switches, pare-feu).
- Supervision technique / infrastructure : serveurs, conteneurs, bases de données, stockage, ressources CPU et mémoire.
- Application Performance Monitoring (APM) : approche plus complète qui combine métriques, logs, traces distribuées et analyse de cause racine.
Une supervision efficace couvre à la fois les aspects techniques, fonctionnels et opérationnels, et gagne à être prévue dès la conception des applications plutôt qu'ajoutée après coup.
La supervision n'est pas la maintenance : elle observe, mesure et alerte. La maintenance, corrective, préventive ou évolutive, intervient ensuite pour corriger et améliorer. Les deux sont complémentaires. Pour replacer la supervision dans une démarche DevOps plus large, consultez notre article Cloud et DevOps : ce que chaque PME devrait savoir.
Enjeux de la supervision : continuité de service et expérience utilisateur
Pourquoi investir dans la supervision applicative ? Parce qu'elle touche directement vos enjeux métiers.
- Continuité de service : une application de facturation, un CRM, une boutique en ligne ou une plateforme de réservation indisponible désorganise l'activité. Une dégradation de performance non détectée peut finir en interruption de service.
- Expérience utilisateur : un site lent, un formulaire qui ne répond pas ou une application mobile qui plante génèrent frustration, abandons et perte de confiance. Des alertes automatisées permettent d'intervenir avant que la situation ne s'aggrave.
- Productivité interne : quand un logiciel métier est indisponible, vos équipes ne peuvent plus travailler. La supervision aide à réduire le temps de détection et de résolution des incidents.
- Traçabilité : la supervision documente chaque événement (date, durée, impact, cause), ce qui est utile pour vos revues internes et vos engagements contractuels.
- Confiance : elle contribue à la disponibilité des services critiques et préserve la confiance de vos clients et partenaires.
Les enjeux de la supervision dépassent donc le périmètre technique : ils concernent toute entreprise en transformation numérique.
Ce que la supervision applicative observe concrètement
La supervision applicative couvre plusieurs couches de votre système d'information :
- Front-end : performance du site web ou de l'application mobile, temps de chargement, interactivité, erreurs JavaScript.
- Back-end : fonctionnement des API et microservices, temps de réponse, taux d'erreur, débit (throughput).
- Base de données : requêtes lentes, verrous, latence.
- Infrastructure : serveurs, conteneurs et services cloud, consommation CPU, mémoire, espace disque.
- Réseau : latence, disponibilité des liaisons, performance du CDN.
Elle collecte en continu trois types de données, souvent appelés les trois piliers de l'observabilité :
- Métriques : taux d'erreur, temps de réponse, nombre de requêtes par minute, utilisation des ressources.
- Logs : journaux d'événements applicatifs, erreurs, avertissements, événements de sécurité.
- Traces : suivi d'une requête de bout en bout, du clic de l'utilisateur jusqu'à l'API, la base de données et la réponse.
Dans un contexte multi-cloud ou hybride, la supervision doit aussi couvrir les services tiers dont dépend l'application : passerelle de paiement, envoi d'e-mails ou de SMS, API partenaires. Sans cette couverture, des angles morts subsistent là où les pannes sont souvent les plus difficiles à diagnostiquer.
Supervision de l'expérience utilisateur : du temps de réponse au taux d'erreur
La supervision de l'expérience utilisateur (Digital Experience Monitoring) va au-delà des métriques techniques : elle mesure la qualité de service telle que la perçoivent vos utilisateurs finaux. Quelques exemples :
- Temps de chargement d'une page de réservation ou d'un tunnel de commande : un ralentissement sur ces pages pèse directement sur la conversion.
- Temps de validation d'un paiement sur un site e-commerce : une attente trop longue augmente le risque d'abandon.
- Taux d'erreur HTTP (4xx/5xx) sur une API : un pic soudain signale un dysfonctionnement à traiter rapidement.
Deux approches complémentaires existent :
- Real User Monitoring (RUM) : collecte des données réelles des utilisateurs (navigateur, appareil, pays, temps de chargement effectif).
- Monitoring synthétique : simulation automatisée des parcours critiques par des robots, pour détecter un problème avant que les utilisateurs réels ne soient touchés.
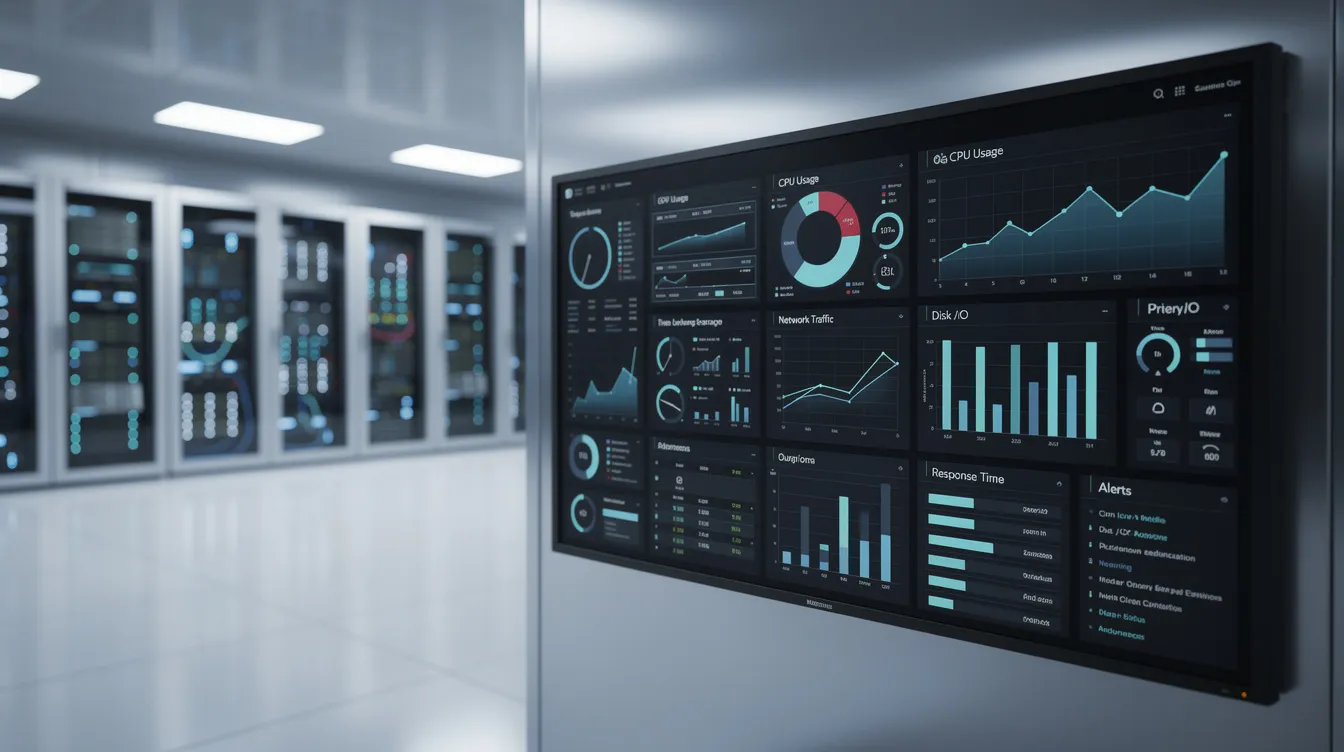
Un tableau de bord en temps réel permet ensuite au support ou au responsable produit de suivre la performance perçue, par pays, navigateur ou type d'appareil.
Indicateurs clés de performance (KPI) à suivre en supervision applicative
Les indicateurs clés de performance transforment des données techniques en informations exploitables. Voici les KPI à configurer en priorité :
- Disponibilité (uptime) : part du temps où l'application est accessible. L'objectif se fixe selon la criticité de chaque application et vos engagements contractuels.
- Temps de réponse moyen et percentiles (p95, p99) : la moyenne ne suffit pas, les percentiles montrent l'expérience des utilisateurs dans les pires conditions.
- Taux d'erreur : erreurs HTTP, exceptions applicatives, échecs de transactions.
- Débit : nombre de requêtes ou de transactions traitées par minute.
- Consommation CPU et mémoire : saturation des serveurs ou des conteneurs.
- Performance de la base de données : requêtes lentes, latence, verrous.
- Files d'attente et tâches planifiées : e-mails en attente, rapports bloqués, jobs en échec.
- MTTR (Mean Time To Resolve) : temps moyen de résolution d'un incident, révélateur de la réactivité de l'organisation.
Formaliser des SLI (indicateurs), SLO (objectifs) et, le cas échéant, des SLA (engagements contractuels) aide à aligner la performance technique sur vos objectifs métier : commandes, réservations confirmées, dossiers traités.
Pour une PME, inutile de suivre des dizaines de métriques. Mieux vaut quelques indicateurs bien configurés, alignés sur les applications critiques et suivis régulièrement.
Tableau pratique : quoi surveiller, pourquoi et exemple d'alerte
Ce tableau peut servir de base pour définir le périmètre de supervision. Les seuils indiqués sont des exemples à adapter à chaque application. Les alertes doivent rester actionnables pour éviter la « fatigue d'alerte » des équipes.
| Ce qu'on surveille | Pourquoi c'est important | Exemple d'alerte (seuils à adapter) |
|---|---|---|
| Disponibilité HTTP du site web | Détecter une panne avant les utilisateurs | « Site inaccessible depuis 2 minutes (erreurs 5xx) » |
| Temps de réponse d'une API critique | Prévenir la dégradation du parcours utilisateur | « Temps de réponse moyen > 2 s pendant 5 minutes sur l'API de paiement » |
| Taux d'erreur applicatif | Identifier un dysfonctionnement logiciel | « Taux d'erreur > 5 % sur les 10 dernières minutes (service réservation) » |
| Saturation CPU / mémoire | Anticiper un ralentissement ou un arrêt | « CPU > 90 % pendant 10 minutes sur le serveur principal » |
| Espace disque | Éviter un arrêt brutal par manque de stockage | « Espace disque restant < 10 % sur le serveur de base de données » |
| Temps de réponse de la base de données | Repérer des requêtes lentes ou des index manquants | « Requête > 5 s détectée sur la table des commandes » |
| Sauvegardes | Vérifier que les sauvegardes s'exécutent | « Échec de la sauvegarde nocturne : aucune sauvegarde depuis 24 h » |
| Latence réseau | Distinguer problème réseau et problème applicatif | « Latence anormale entre l'application et la base de données » |
Outils de supervision : du simple monitoring aux plateformes APM
Le choix des outils dépend de votre environnement et de votre niveau de maturité. Les grandes familles :
- Outils de supervision d'infrastructure : serveurs, réseau et équipements (CPU, mémoire, disque, bande passante).
- Plateformes APM : collecte de données télémétriques comme le temps de réponse et le taux d'erreur, traçage distribué et analyse de cause racine, pour détecter les anomalies avant qu'elles n'affectent les utilisateurs.
- Outils de logs et de traces : collecte, agrégation, recherche et corrélation des journaux. OpenTelemetry est un standard ouvert d'instrumentation qui facilite l'interopérabilité entre outils.
- Tableaux de bord et visualisation : des outils comme Grafana centralisent métriques, alertes et état de santé global.
Centraliser logs, métriques et traces facilite le diagnostic et évite de multiplier des logiciels redondants.
Grafana fait partie des technologies qu'Unziptech utilise en production, aux côtés de Docker, PostgreSQL ou Cloudflare. L'exploitation de RentalMe, place de marché de location de voitures conçue, développée et maintenue par Unziptech, repose sur une supervision continue.
Pour une PME ou une ETI, les critères de choix sont : simplicité d'usage, intégration avec l'existant (cloud, sur site, hybride), capacités d'alerte, clarté des tableaux de bord et coût de mise en place. Privilégiez une approche progressive : commencez par vos applications métier et vos services critiques plutôt que de vouloir tout superviser d'emblée.
Comment mettre en place une démarche de supervision applicative progressive
Mettre en place une supervision applicative peut se faire par étapes, quelle que soit la taille de l'entreprise :
Étape 1 – Identifier les applications critiques. Listez vos applications par ordre de priorité : site vitrine, boutique en ligne, ERP, CRM, plateforme SaaS, portail client.
Étape 2 – Cartographier les dépendances. Pour chaque application, identifiez les briques dont elle dépend : serveurs, bases de données, API tierces, réseau, sauvegardes. Cette cartographie indique quoi superviser en priorité.
Étape 3 – Choisir quelques indicateurs clés. Sélectionnez des indicateurs alignés sur vos enjeux : disponibilité, temps de réponse, taux d'erreur, espace disque, réussite des sauvegardes.
Étape 4 – Déployer et configurer. Installez l'outil retenu, configurez les sondes et tableaux de bord, puis validez les seuils d'alerte avec les équipes métiers et IT.
Étape 5 – Organiser le traitement des alertes. Définissez qui reçoit quoi, à quels horaires et par quels canaux (e-mail, SMS, messagerie, outil de ticketing), et documentez la procédure pour chaque type d'incident.
La formation des équipes compte autant que l'outil : sans appropriation, même une bonne plateforme reste sous-exploitée. Unziptech peut vous accompagner sur ces étapes, de l'audit de l'existant au déploiement, avec une formation incluse à chaque livraison.
Checklist supervision applicative pour dirigeants et responsables IT
Utilisez cette checklist pour évaluer votre niveau de maturité :
- ☐ Mes applications critiques sont identifiées et classées par priorité.
- ☐ Je connais les temps de réponse acceptables pour mes utilisateurs.
- ☐ Je reçois une alerte si une sauvegarde échoue.
- ☐ Je dispose d'un tableau de bord simple montrant l'état de santé de mes applications.
- ☐ Mes incidents majeurs sont tracés (date, durée, impact, cause).
- ☐ J'ai une visibilité minimale sur le réseau (disponibilité des liens, latence) pour distinguer problème applicatif et problème réseau.
- ☐ Un responsable de la supervision est clairement désigné.
- ☐ Les alertes sont en nombre raisonnable et réellement traitées.
- ☐ Les seuils d'alerte sont réévalués régulièrement.
- ☐ J'analyse les tendances de performance sur la durée pour anticiper les besoins en ressources.
Chaque case non cochée est une piste d'amélioration concrète.
Supervision, maintenance applicative et plan de reprise : une chaîne continue
Seule, la supervision détecte et alerte. C'est son articulation avec la maintenance, les sauvegardes et le plan de reprise qui assure la continuité.
- Supervision → maintenance : la supervision détecte une anomalie, la maintenance corrective la résout. Mises à jour de sécurité, correctifs et optimisations relèvent de la maintenance préventive et évolutive. Pour approfondir : maintenance d'application web.
- Supervision → sauvegardes : une supervision bien configurée vérifie que les sauvegardes s'exécutent et alerte en cas d'échec. Sans ce contrôle, le problème n'apparaît qu'au moment où l'on a besoin de restaurer. Voir notre guide sur la sauvegarde des données en entreprise.
- Supervision → plan de reprise d'activité (PRA) : journaux d'incidents, temps de détection, temps de reprise et services touchés alimentent votre PRA et aident à dimensionner les procédures de reprise. Consultez notre article sur le plan de reprise d'activité.
Trois scénarios illustratifs
Ces scénarios génériques montrent l'apport de la supervision ; ils ne décrivent pas des projets clients.
Scénario 1 – Le site web lent à certaines heures. Une entreprise constate que son site devient très lent à certains moments, sans en connaître la cause. Sans supervision, impossible de savoir si le problème vient du réseau, de l'application ou de l'infrastructure. En croisant supervision réseau et supervision applicative, l'équipe peut par exemple découvrir que la base de données est saturée par des requêtes lentes.
Scénario 2 – Les sauvegardes qui échouent en silence. Personne ne surveille les sauvegardes d'une application métier. Lors d'une panne, on découvre qu'elles échouaient depuis des semaines. Une simple alerte quotidienne sur l'état des sauvegardes aurait révélé le problème à temps.
Scénario 3 – Le pic saisonnier non anticipé. Une plateforme de réservation connaît un pic de trafic. Sans suivi des temps de réponse et des taux d'erreur, les ralentissements passent inaperçus au moment clé. Des seuils bien calibrés permettent d'adapter les ressources à temps, sans noyer l'équipe sous les alertes.
FAQ : supervision applicative
Quelle est la différence entre supervision informatique, supervision réseau et supervision applicative ?
La supervision informatique englobe toutes les couches : réseau, infrastructure, applications, sécurité. La supervision réseau surveille la connectivité, la bande passante et les équipements. La supervision applicative se concentre sur le fonctionnement et la performance de vos applications. Par exemple, si votre site est lent alors que la liaison Internet est correcte, la supervision applicative peut révéler que la base de données répond trop lentement.
Quels indicateurs suivre en priorité dans une PME ?
Pour démarrer : disponibilité, temps de réponse, taux d'erreur et réussite des sauvegardes. Ces indicateurs couvrent les besoins de base ; vous les affinerez ensuite selon votre contexte et vos objectifs métier.
La supervision remplace-t-elle la maintenance applicative ?
Non. La supervision observe et alerte ; la maintenance corrige, optimise et fait évoluer. L'une nourrit l'autre : sans supervision, la maintenance manque de données ; sans maintenance, les alertes restent sans suite.
Faut-il une équipe DevOps pour mettre en place une supervision ?
Non. Un responsable IT ou un prestataire externe peut mettre en place une supervision efficace sur les applications critiques. L'essentiel est de disposer d'un référent capable de configurer les outils, d'interpréter les alertes et de déclencher les actions correctives.
En quoi la supervision améliore-t-elle l'expérience utilisateur ?
Elle détecte les lenteurs, les erreurs et les indisponibilités dès leur apparition, idéalement avant que les utilisateurs ne les subissent. Vous intervenez plus vite et limitez les interruptions de service.
Combien de temps faut-il pour démarrer une supervision minimale ?
Cela dépend de la complexité de votre environnement et du nombre d'applications à couvrir. Un audit de l'existant permet de dimensionner la démarche et de commencer par les briques les plus critiques.
Passer d'une supervision subie à une supervision pilotée
La supervision applicative n'est pas réservée aux grandes structures. Elle protège vos services critiques, améliore l'expérience utilisateur, alimente vos indicateurs de performance et renforce la chaîne qui relie maintenance, sauvegarde et plan de reprise d'activité. L'approche la plus réaliste reste progressive : commencer par l'essentiel, mesurer, ajuster, élargir.
Unziptech conçoit, développe et maintient des applications web, mobiles et métier, et propose le conseil IT (audit de l'existant, architecture, feuille de route) ainsi que l'hébergement, la supervision et la sauvegarde des plateformes en ligne. Découvrez nos services ou demandez un devis gratuit via notre page de contact : réponse sous 24 h.